 李鉉道SMHC株式会社 代表取締役
AI競争の本当の勝者は、 「最も賢いモデル」を作った企業なのでしょうか。
それとも、
世界中の開発者、そしてAIエージェントから「使われる土台」を作った企業なのでしょうか。
2026年8月、Hugging Faceが公開した最新データから、AI競争のルールそのものが変わり始めていることが見えてきます。
注目したいのは、中国のオープンモデルです。
これまで中国AIについては、
「いつGPTに追いつくのか」 「いつClaudeに追いつくのか」
という議論が多くありました。
しかし、これから問うべきなのは、
「世界がAIを作るとき、中国発モデルを土台として選ぶケースがどこまで増えるのか」
なのかもしれません。
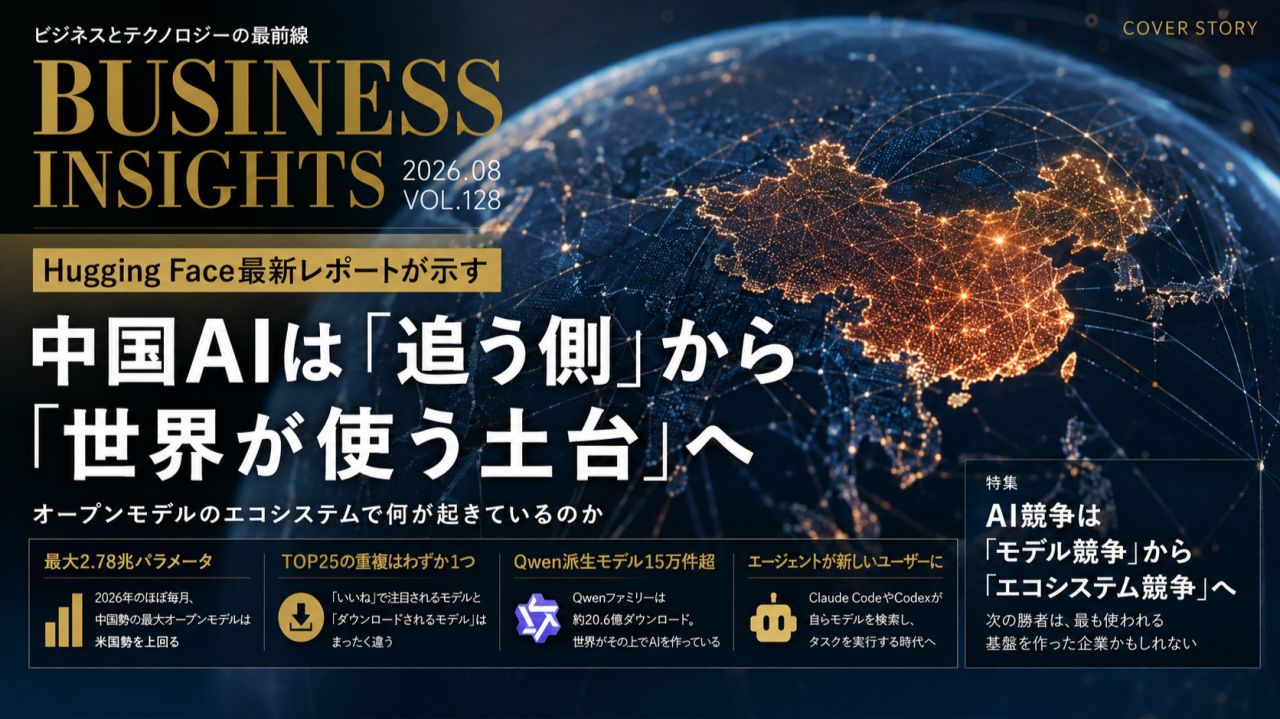
① 最大2.78兆パラメータ。中国勢がオープンモデルの最前線へ
Hugging Faceによれば、2026年のほぼ毎月、中国の研究機関・企業が公開した最大級オープンモデルは、米国勢のモデルより大規模でした。
中国勢の月間最大モデルは7540億〜2.78兆パラメータ。
一方、米国勢は最初の7カ月のうち5カ月で最大モデルが1300億パラメータ未満でした。
もちろん、
「パラメータが大きい=性能が高い」ではありません。
ここは明確に区別する必要があります。
むしろ重要なのは、その次のデータです。
② 「注目されるモデル」と「使われるモデル」はまったく違う
Hugging Faceが2026年の
・ダウンロード数TOP25 ・「いいね」数TOP25
を比較したところ、両方に入ったモデルはわずか1つでした。
これは非常に興味深い。
「いいね」は市場からの注目を示す。
一方、ダウンロードは実際の開発パイプラインなどへの組み込みを示す一つの指標です。
つまり、
「話題になるAI」と「実際に使われるAI」は必ずしも同じではない。
AI業界でも、最終的にはベンチマークや発表会以上に、
「実際の仕事に組み込まれているか」
が重要になってくると考えています。
③ Qwen派生モデル、15万件超
さらに象徴的なのがAlibabaのQwenです。
Hugging Face上でQwenをベースに作られた派生モデルは、
151,448件。
これはMeta全体の派生モデル数の約2.6倍、Llama関連リポジトリだけと比較すると約4.7倍です。
さらにQwenファミリーは、2026年の対象期間で約20.6億ダウンロードに達しています。
重要なのは数字そのものだけではありません。
15万件以上の派生モデルの多くは、Qwen自身ではなく、世界中の開発者によって作られています。
つまり中国モデルは、
「ダウンロードされている」
だけではなく、
「その上で次のAIが作られている」
段階に入り始めています。
④ 米国モデルにも中国発技術を利用する事例
さらにHugging Faceは、2026年に米国から公開された1000億パラメータ超の一部モデルについて、
中国モデルをベースにしたもの、あるいは中国の研究機関が公開した成果を利用したものがある
と指摘しています。
具体例として、Thinking Machines Labの「Inkling」が挙げられています。
これは「米国AIが中国AIに依存している」という意味ではありません。
NVIDIAなど米国企業も独自の大規模オープンモデルを開発しています。
しかし、
中国発のAI技術が、世界のAI開発エコシステムの構成要素になり始めている。
ここは数年前とは大きく異なるポイントだと思います。
⑤ 中国勢の武器は「オープン性」
なぜ中国のオープンモデルが急速に広がっているのか。
一つの答えがライセンスです。
Hugging Faceの調査では、2026年に中国勢が公開した200億パラメータ超の178モデルのうち、
59%がApache 2.0 22%がMIT
でした。
合計すると約81%。
米国勢の同規模モデルではApacheまたはMITは29%でした。
改変、再配布、商用利用などのハードルを下げることで、
利用者が増える ↓ 派生モデルが増える ↓ ツールが増える ↓ さらに利用者が増える
というネットワーク効果が生まれます。
ただし、ここにも変化があります。
Hugging Face自身が指摘しているように、最近の超大型モデルの一部では、非商用制限や収益分配条件などを含むライセンスも出始めています。
つまり今後は、
「完全に開く」から「エコシステムを広げながらどう収益化するか」
へ競争が移っていく可能性があります。
⑥ 実際に大量に使われているのは「小さなAI」
もう一つ、経営者として非常に重要だと思った数字があります。
パラメータ数が明示されているHugging Faceモデルでは、
10億パラメータ未満の小型モデルが、累計ダウンロードの83%を占めています。
1000億パラメータ超はわずか1%。
つまり企業へのAI実装では、「一番大きいモデル」が必ずしも正解ではありません。
実際のビジネスでは、
安い 速い 安定している 自社環境で動かせる セキュリティを管理できる
といった条件が重要になります。
私はこの変化を、
大規模モデルが競うのは「どれだけ賢いか」。 AIエージェントが競うのは「仕事を最後までやり切れるか」。
という違いだと考えています。
⑦ そして次の「ユーザー」は人間ではなくAIになる
今回のHugging Faceレポートで、個人的に最も重要だと思ったのがここです。
Hugging Faceは、
「Agents are the new user(エージェントが新しいユーザーになる)」
という変化を取り上げています。
実際、Claude CodeやCodexなどのコーディングエージェントがHugging Face Hubへアクセスし、
モデルを検索したり、 データセットを扱ったり、 ジョブを実行したりするトラフィックが観測されています。
2026年7月のエージェント由来トラフィックではClaude Codeが44.4%。
Codexも4月の10.4%から7月には20.8%まで上昇しました。
ここから先は私の考察ですが、非常に大きな意味を持つと思います。
これまでAIプラットフォームが獲得しようとしていたのは、
「人間の開発者」でした。
これからは、
「AIエージェントから選ばれるエコシステム」
という競争が始まる可能性があります。
呼び出しやすい。 APIやツールが豊富。 ライセンスが扱いやすい。 ローカルでも動く。 大量の派生モデルが存在する。
こうした条件を満たしたモデルが、AI自身によって選択される。
もしそうなれば、オープンエコシステムの価値は今以上に大きくなるでしょう。
AI競争は「モデル競争」から「エコシステム競争」へ
中国AIについて本当に注目すべきなのは、
「米国を抜いたか」
という単純なランキングではないと思います。
もっと重要なのは、
世界中の開発者が中国モデルを使い、その上に新しいAIを作り始めていること。
かつて中国は、OS、半導体、基盤ソフトウェアなど、多くの領域で海外発の技術基盤を利用して成長してきました。
しかしAIでは、その構図の一部が変わり始めています。
以前は、
「他者の肩に乗って追いかける側」だった。
今は、
「世界の誰かが、その肩に乗って次のAIを作る側」
にもなり始めている。
AI時代の本当の競争優位とは、
「世界一のモデルを一度作ること」ではなく、
世界中の開発者、企業、そして将来的にはAIエージェントから、当たり前のように使われる基盤になること
なのかもしれません。
モデルは変わります。
ランキングも変わります。
しかし一度形成されたエコシステムは、簡単には入れ替わりません。
だから私は、次のAI競争で見るべきKPIは、
「誰が一番賢いか」だけではなく、 「誰の上に、最も多くのAIが作られているか」
だと考えています。
皆さんはどう思いますか?
中国発のオープンモデルは、次世代AIの「標準基盤」の一角になっていくでしょうか。
ぜひコメントで意見を聞かせてください。
参考・ファクトチェック
本記事はHugging Faceが2026年8月14日に公開した「State of Open Models: Summer 2026 Observations」を中心に確認・再構成しています。
なお、Hugging Face自身も、ダウンロード数はHub内での利用を示す指標であり、API利用、非公開環境への導入、他チャネルでの配布などは含まないため、AI市場全体のシェアを示すものではないと注意しています。
#AI #生成AI #OpenSource #Qwen #AIエージェント #LLM #中国AI #DX #AI戦略
この記事は2026年8月30日にLinkedInで公開したものです。LinkedInの元記事でコメントする
CEOブログ一覧に戻る